Коротко: сессия с памятью MaxGraph стартует на ~4 200 токенах контекста против ~8 900 у чтения проекта с нуля — в 2,1 раза меньше (честный диапазон 1,4–3,3×). На точечных вопросах по нескольким файлам — до 4,2×. В заголовке стоит −43% — это нижняя граница, а не маркетинговый максимум.
Ритуал, который никто не считает
Открыл новый чат — объясни проект заново. Стек, договорённости, «вчера чинили баг в авторизации», «деплой только через скрипт с preflight». Каждый, кто работает с агентом дольше одной сессии, делает это ежедневно. Ритуал настолько привычный, что его стоимость никто не меряет.
Мы измерили. Проект — MaxGraph сам (репозиторий v0.18.3), задача — старт рабочей сессии до первого полезного ответа агента.
Методика
Четыре сценария старта над одним проектом:
- A. С памятью. Агент вызывает
session_start(дайджест графа с жёстким бюджетом ~10 000 символов) и делает один точечный поиск. - B. С нуля. Агент читает README, протокол работы, последние 5 версий CHANGELOG и текст лендинга — минимум, чтобы понять проект. Плюс 10% на навигацию между файлами.
- B2. Ручной брифинг. То же, но владелец пишет вводную на 1 000–1 500 символов, и агенту всё равно нужны README и протокол.
- C. Точечный вопрос. «Какой статус у задачи X» — один поиск по памяти против чтения одного или двух файлов.
Токены считались по символьной эвристике (RU ≈ 2,5 симв/токен, EN ≈ 3,8), потому что tiktoken в окружении отсутствовал. Это оценка, а не биллинг — поэтому дальше везде диапазоны, а не красивые точки.
Результаты
| Сценарий | Токены на старт | Против памяти |
|---|---|---|
A. MaxGraph (session_start + 1 поиск) | ~4 200 (3 300–5 100) | 1× |
| B. Чтение проекта с нуля | ~8 900 (7 300–11 000) | 2,1× (1,4–3,3×) |
| B2. Ручной брифинг | ~5 300 (4 300–6 700) | 1,3× (0,8–2,0×) |
| C. Точечный вопрос: память | ~1 000 | 1× |
| C. Точечный вопрос: 2 файла | ~4 300 | 4,2× (3,0–6,8×) |
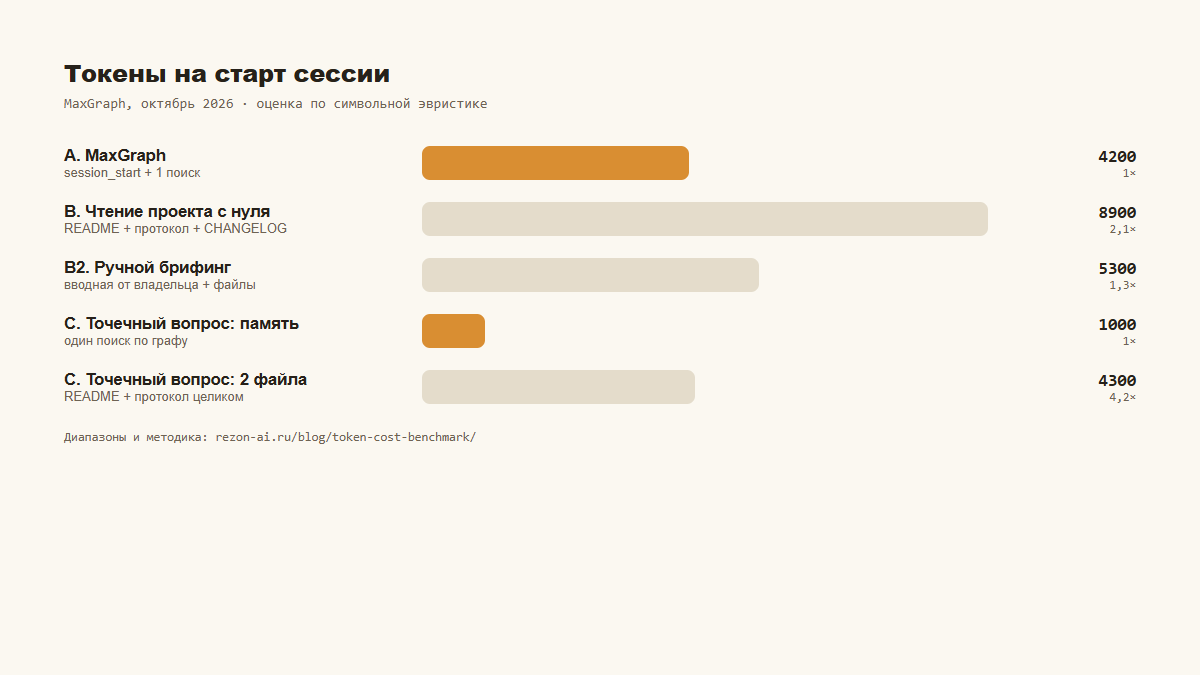
Три вывода, которые нас самих удивили:
Память не бесплатна. Дайджест session_start стоит 2 500–3 900 токенов в каждой сессии — мы включили это в сценарий A. Экономия — не магия, а разница между «прочитать ровно нужное» и «прочитать всё подряд».
Хороший ручной брифинг конкурентен по токенам (1,3×, на нижней границе — паритет). Разница в другом: брифинг пишет человек, каждый раз, и он неполон. В графе на момент замера лежали 24 решения владельца, 97 событий и статусы задач — столько в вводную руками не упакуешь.
Против одного маленького файла память может проиграть (нижняя граница 0,9×): если ответ лежит в README, дешевле прочитать README. Память выигрывает там, где ответ размазан по нескольким источникам, — и на состоянии «кто что решил», которого в файлах нет вообще.
Почему −43%, а не −60%
Среднее по честному диапазону сценария B — экономия около 53%. Мы взяли для заголовка консервативную оценку: смешанная нагрузка из стартов «с нуля» и ручных брифингов даёт ≈1,7× — это и есть ~43%. Лучше занизить и показать методику, чем наоборот.
И ещё одна асимметрия: бюджет дайджеста памяти зафиксирован, а CHANGELOG и документация только растут (полный CHANGELOG — уже ~21 000 токенов). Сегодняшние 2,1× со временем станут больше — цена памяти при этом не изменится.
Как повторить
Репозиторий открыт, Docker и десять минут:
git clone https://github.com/RuMemory/maxgraph
cd maxgraph
docker compose up -d
# токен доступа: data/local_token.txt
Подключите к своему агенту по MCP, поработайте неделю и сравните свои старты сессий. Нам интересны чужие цифры — напишите на help@rezon-ai.ru.
Дай своему агенту память
Триал 7 дней без карты. Установка — один промпт, дальше агент сделает сам.