Коротко: Apple опубликовала пейпер Minions (arXiv, октябрь 2026) — внутреннюю систему, которая объединяет простаивающие GPU на Mac сотрудников в распределённое облако для ML-инференса. Задачи ждали централизованного GPU по 10+ часов — с Minions они стартуют за минуты, а закупать железо не пришлось. Архитектура предельно прагматичная: PostgreSQL как источник правды, никакого центрального планировщика, Ollama на каждом Mac.
Проблема: GPU ждут часами, а рядом простаивают сотни Mac
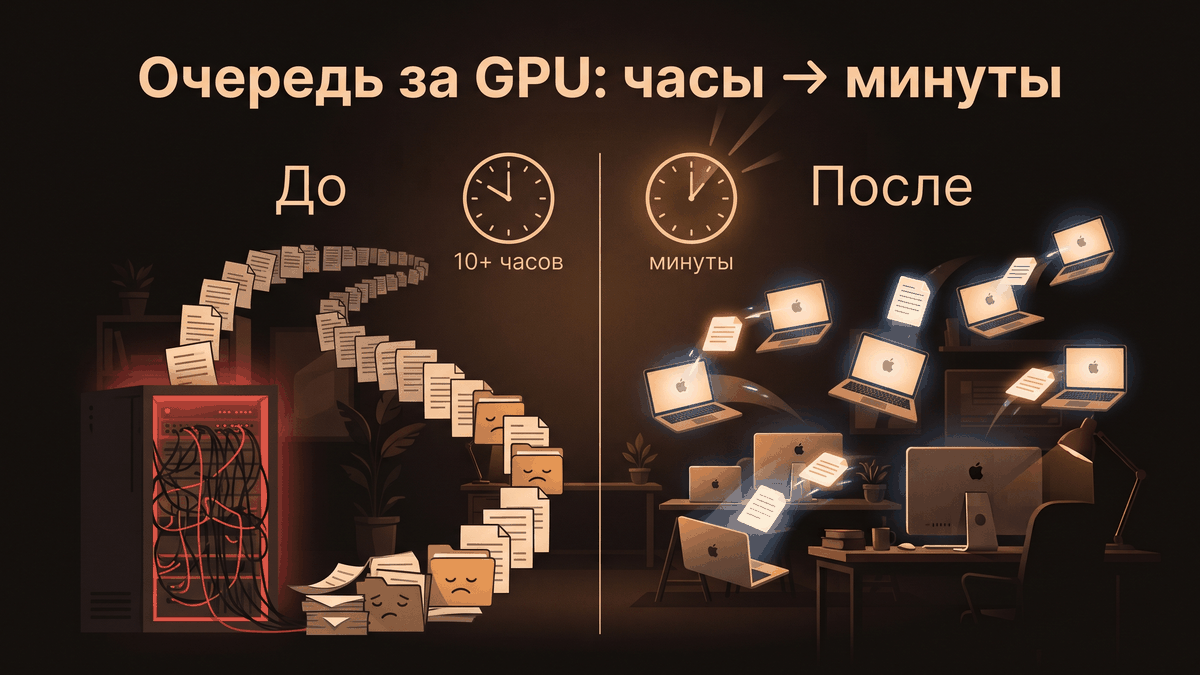
В любой крупной компании ML-инференс живёт на централизованных GPU-кластерах: они дорогие, их вечно не хватает, и задачи стоят в очереди. В пейпере честно названа цифра: отдельные инференс-задачи ждали в очереди больше десяти часов.
При этом под столами инженеров стоят Mac с Apple Silicon — с вполне взрослыми GPU, которые большую часть дня не делают ничего. Вопрос, на который отвечает Minions: можно ли собрать из этого паразитного капацитета рабочее облако — без единой новой закупки?
Ответ: да, и это работает в проде у нескольких команд Apple.
Архитектура: четыре компонента и никакой магии
Система состоит из четырёх частей:
- Minion Server — координатор с веб-интерфейсом и REST API. Принимает задачу, валидирует параметры и асинхронно режет её на подзадачи.
- PostgreSQL — единственный источник правды: все задачи, подзадачи, состояния исполнителей и хартбиты. Всего семь таблиц.
- Minion Executor — агент на macOS-устройстве. Тянет подзадачи из сервера по REST, выполняет на локальном GPU, пишет результат в S3, шлёт хартбит каждые пять минут.
- Minion Watchdog — следит за исполнителями. Если устройство уснуло, потеряло сеть или владелец выключил агента — недоделанная подзадача возвращается в очередь и её подхватывает другой исполнитель.
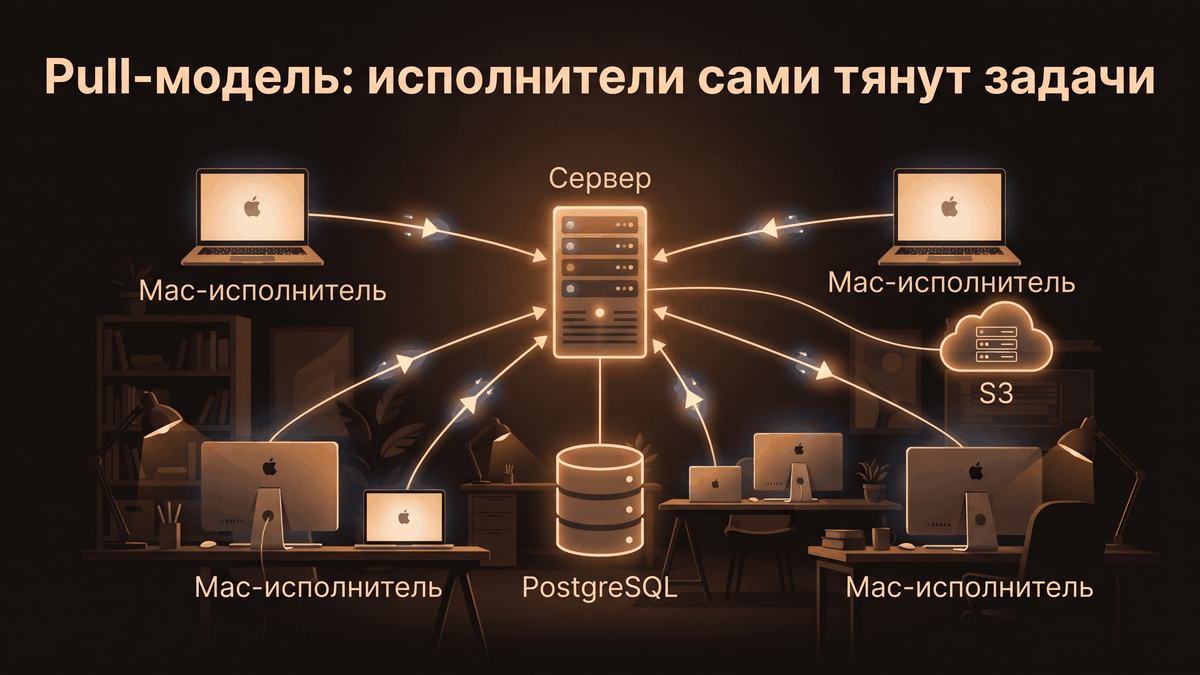
Два решения делают систему простой и живучей.
Нет центрального планировщика. Исполнители сами тянут подзадачи (pull-модель). Захват подзадачи — гонка INSERT в таблицу minion_subtask_acquirement с уникальным констрейнтом по кортежу (team, project, task_name, subtask_id). Кто вставил — тот и владелец, остальные получают ON CONFLICT DO NOTHING и берут следующую. Вся мьютекс-логика — одна уникальная пара в Postgres.
Сбой — норма, а не исключение. Watchdog следит только за исполнителями, которые прямо сейчас что-то считают (а не за всеми зарегистрированными) — это дёшево и масштабируется. Устройство ушло спать посреди подзадачи? Подзадача просто вернётся в очередь.
Что там крутится: эмбеддинги и LLM на Ollama
Система поддерживает два класса нагрузок, и оба — про локальный инференс:
- Генерация эмбеддингов — открытые трансформеры с HuggingFace через Python API.
- Комплишн LLM — через Ollama, установленную на каждом участвующем Mac. Никаких внешних API-вызовов: модель кэшируется локально, инференс идёт на месте.
Входы и выходы лежат в S3 — вычисление отделено от хранения, большие полезные нагрузки не гоняются через сервер координации.
Есть и приятно-человеческая деталь: приоритеты разруливаются отчасти вручную — команда просто пишет в Slack коллегам «запустите, пожалуйста, executor на вечер». Для срочных задач есть динамическая привязка: владелец устройства может настроить своего исполнителя предпочитать конкретный проект, а когда в приоритете пусто — берётся общая FIFO-очередь.
Цифры
| Метрика | До Minions | С Minions |
|---|---|---|
| Очередь за GPU | Часы (до 10+) | Минуты |
| Заявки на новые GPU | Требовались | Не нужны |
| Стоимость инфраструктуры | Высокая | Ноль |
| Масштабирование | Ручное | Органичное |
Честная оговорка: пейпер — три страницы, это позиционная заметка об опыте, а не бенчмарк. Пропускной способности, распределения по моделям и сравнения стоимости за токен там нет.
Ложка дёгтя: чужие данные на чужих столах
Авторы прямо пишут о главном тормозе внедрения: конфиденциальность. Запускать свою нагрузку на Mac коллеги из другого отдела — уже вопрос доверия, даже внутри одной компании. Решение у Minions организационное, а не криптографическое: деплой с границей команды — отдельная PostgreSQL и изолированный пул исполнителей.
И это, пожалуй, самое интересное в пейпере. Самая горячая проблема распределённого вычисления оказалась не технической, а социальной: у кого лежат данные, тому они и важны.
Почему это близко нам
Minions бьёт по двум темам, которыми мы живём.
Первая — локальный инференс как норма. Apple внутри компании гоняет эмбеддинги и комплишн LLM на обычных Mac через Ollama — потому что это бесплатно, быстро и не требует ничьего разрешения. MaxGraph устроен так же: embedding-модель крутится на вашей машине или вашем сервере, память агента — файл у вас, а не строка в чужой базе. Когда Apple пишет, что «простаивающее железо — это облако», local-first перестаёт быть маргинальной философией.
Вторая — данные хотят жить у владельца. Проблему конфиденциальности Minions решает границами доверия. Мы решаем её радикальнее: память агента вообще не покидает вашу машину — границы доверия просто не нужны, когда делиться не во что.
FAQ
Minions — опенсорс? Нет. Это пейпер об опыте Apple, кода в открытом доступе нет. Но архитектура описана достаточно, чтобы собрать аналог: pull-модель, Postgres с уникальным констрейнтом на захват подзадачи, watchdog по хартбитам, Ollama на узлах.
Можно ли такое дома / в маленькой команде? Идея масштабируется вниз отлично: два Mac в офисе и Postgres на NAS — уже рабочая схема для пакетных эмбеддингов. Ollama из коробки даёт LLM-инференс на Apple Silicon.
Это замена облачным GPU? Для инференса — частично. Для обучения нет: авторы сами называют distributed training направлением будущей работы. И «облако из Mac» не про пиковую производительность, а про утилизацию того, что уже куплено.
Причём тут вообще память агентов? Прямо: генерация эмбеддингов — одна из двух нагрузок Minions. Тот же класс задач, который MaxGraph выполняет при семантическом поиске по графу памяти. Локальный инференс эмбеддингов — это то, что позволяет нашему поиску не отправлять ваши данные наружу.
Что дальше
- Почему локальный инференс — это ещё и деньги: замеры экономии токенов.
- Как устроен гибридный поиск по памяти: граф + векторы.
- Память агенту за 10 минут: гайд для Claude Code.
Дай своему агенту память
Триал 7 дней без карты. Установка — один промпт, дальше агент сделает сам.